Etiquetas

C (31) Cpp (28) Linux (14) asm (8) Telegram (5) bot (5) libreria (5) Algoritmo (3) Errores comunes (3) python (3) Opengl (2) kali (2) Android (1) Snippet (1) nano (1) recursividad (1)

viernes, 12 de abril de 2024

ELF Basics Internal: Elf Basics.

/*Este material no lo hice yo. Source: oxhat.blogspot.com*/ In this post I will share details on ELF binary basics.

So let is begin with a very simple hello world program in C

#include stdio.h

int main(){printf("\nHello World\n");return 0;}

As I am on a 64 bit Linux system I will compile the binary for both 32bit and 64bit mode.

We will compile this code with gcc by issuing the command
for 64 bit -> gcc hello.c -o hello64
for 32 bit -> gcc hello.c -m32 -o hello32

, ( in case we get error we can install gcc multilib by issuing command sudo apt-get install gcc-multilib ) If we issue file command on the binary we created we would see the following output

pentest@ubuntu:~/Desktop$ file hello64 hello64: ELF 64-bit LSB shared object, x86-64, version 1 (SYSV), dynamically linked, interpreter /lib64/ld-linux-x86-64.so.2, for GNU/Linux 3.2.0, BuildID[sha1]=797fa6ea8a92b773eb5106c822a76788441ceac1, not stripped
pentest@ubuntu:~/Desktop$ file hello32 hello32: ELF 32-bit LSB shared object, Intel 80386, version 1 (SYSV), dynamically linked, interpreter /lib/ld-linux.so.2, for GNU/Linux 3.2.0, BuildID[sha1]=ba188ad09ee9ff9ac774833b8a7c87d8afbc443a, not stripped

So let us try to understand what all these mean (we will analyze the result of 64 bit binary)
hello64: ELF 64-bit LSB shared object, x86-64, version 1 (SYSV), dynamically linked, interpreter /lib64/ld-linux-x86-64.so.2, for GNU/Linux 3.2.0, BuildID[sha1]=797fa6ea8a92b773eb5106c822a76788441ceac1, not stripped

hello64: This is the filename of the binary on which we are executing the file command
ELF - Executable and Linking Format or Executable and Linkable Format - This mean that the binary type is associated with mainly UNIX type operating system , like Linux, Solaris but also supports certain non UNIX operating system.
64bit - This gives us information tells about the architecture of the binary that it is 64 bit. So if it is a 32 bit binary it will be shown as 32 If we are in a 64bit machine and if we want to create a 32 bit binary we can pass the -m32 option
LSB - Least Significant Byte - It means the binary is in little endian format. In Intel architecture you will often find this as LSB. However in architectures like PowerPC , SPARC and so on it is possible to get this in big endian format i.e MSB ( Most Significant Byte )
Shared object - This result can either be Shared Object or Relocatable or Executable.
Let us see how these are different from each other and how we can generate them using gcc. The two terms which we are going to use here are PIC ( Position Independent Code ) and PIE ( Position Independent Executable) .
When we are planning to create a library that can be called by many process, we need to make it a PIC so that they can be loaded in the memory at any virtual address and just because they are position independent it can be accessed with relative offsets without worrying about the clashes of fixed locations in memory. We can create a PIE when Shared Object - By default the gcc compiler compiles the source code with -fPIC which makes address of the sections in the program relative to each other.
Executable - This mean this is not a PIE application. This loads with absolute address and thus we can find no reference of .plt.got sections here as the program is loaded in memory with fixed address .We can disable PIE with -no-pie option in gcc and thus we will get a executable object file.
Relocatable - This means this is just an object code without any linking of libraries or files that are necessary for the execution.
There are some steps involved when we make a program that can be executable ( Please Note: The term executable here means here is to make it run or execute and should not be confused with the above executable object type ).
To make an executable from source program the following process is involved.
Preprocessing -> Compilation -> Object File Creation -> Linking.

Normally in gcc we do in one step like gcc hello.c -o hello.out
but however we can do in 2 steps like gcc -c hello.c ; this will create an object file called hello.o This is how the disassembly of main looks like in object code.
0000000000000000 <main>:
0: 55 push rbp
1: 48 89 e5 mov rbp,rsp
4: 48 8d 3d 00 00 00 00 lea rdi,[rip+0x0] # b <main+0xb>
b: e8 00 00 00 00 call 10 <main+0x10>
10: 90 nop
11: 5d pop rbp
12: c3 ret

This program cannot run or do anything because the object code doesn't have the necessary linked objects or libraries required for execution. We can generate an executable binary from object code using the command
gcc hello.o -o hello-executable Now if we run objdump on the binary we can see lots of sections getting created with the location to the linkers.
This is how the disassembly of main looks like after linking
000000000000063a <main>:
63a: 55 push rbp
63b: 48 89 e5 mov rbp,rsp
63e: 48 8d 3d 8f 00 00 00 lea rdi,[rip+0x8f] # 6d4
<_IO_stdin_used+0x4>
645: e8 c6 fe ff ff call 510
<puts@plt>
64a: 90 nop
64b: 5d pop rbp
64c: c3 ret
64d: 0f 1f 00 nop DWORD PTR [rax]

Nota: Lo marcado con fondo rojo va al final de la línea anterior.
version 1 (SYSV) - This means that it uses version 1 and the target operating system for the binary is SYSTEM V. There can be other possible values for this for example FreeBSD, HP-UX , etc,. I didn't get enough resource from where I can find more details on the version 1 result and how it can affect something.

Dynamically linked, interpreter /lib/ld-linux.so.2, - It means that the binary uses some dynamically linked libraries. There is 2 possible values possible for this.Dynamically linked and Statically Linked.

Dynamically Linked - It means the linker actually uses a reference to load dynamically linked libraries in memory during execution of the program from the location /lib/ld-linux.so.2
We can verify it by running the ldd on the binary
pentest@ubuntu:~/Desktop$ ldd hello64
linux-vdso.so.1 (0x00007fff96bc2000)
libc.so.6 => /lib/x86_64-linux-gnu/libc.so.6 (0x00007f425eb2a000)
/lib64/ld-linux-x86-64.so.2 (0x00007f425f11d000)

Statically Linked - It means that the binary has been packed along with the libraries. So there is no dynamically linked libraries inside it. So if a binary is compiled with -shared option in gcc it will create a statically linked binary. So if we run ldd command on the binary it will tell that there is not a dynamic executable.
pentest@ubuntu:~/Desktop$ ldd helloStatic
not a dynamic executable
There is a huge difference in sizes of the binary when compiled with -shared option ( i.e statically )
-rwxrwxr-x 1 pentest pentest 8296 Feb 6 08:55 hello64
-rwxrwxr-x 1 pentest pentest 844704 Feb 7 09:28 helloStatic
At this point you might feel confused between the relocation of the binary that we discussed before and the linking which we are discussing now. Well when we talk about shared object or executable or relocatable object type, then we are actually dealing how the program will be loaded in memory but when we talk about linking, then it is all about how the external libraries will be linked to binaries - either dynamically via some shared resources or statically by packing it with the actual binary. So we can make this statement , an executable object type may have dynamic linked libraries. Than means even if we disable PIE we can still get an executable with dynamically linked libraries.
pentest@ubuntu:~/Desktop$ file helloNOPIE
helloNOPIE: ELF 64-bit LSB executable, x86-64, version 1 (SYSV), dynamically linked, interpreter /lib64/ld-linux-x86-64.so.2, for GNU/Linux 3.2.0, BuildID[sha1]=2d986bca273f541af7a48ffb51f4d5fd22177c22, not stripped

pentest@ubuntu:~/Desktop$ ldd helloNOPIE
linux-vdso.so.1 (0x00007ffffe990000) libc.so.6 => /lib/x86_64-linux-gnu/libc.so.6 (0x00007fcb5e8c0000) /lib64/ld-linux-x86-64.so.2 (0x00007fcb5ecb1000)
for GNU/Linux 3.2.0 - The minimum kernel version required to execute the binary BuildID[sha1]=ba188ad09ee9ff9ac774833b8a7c87d8afbc443a - This ID is assigned to the binary during the build phase. Possibly during the linking phase as this is not visible in object code after compilation.
not stripped - This means that the certain but not all debugging information are available. It can also have a value stripped in case we remove the debug symbols. A stripped binary is smaller in size than an not stripped binary. When we strip a binary we remove some extra sections from a binary that is not relevant or required for execution but was added for making debugging easy. We can verify using gdb and we can keep debug symbols in a binary by compiling with -g option
pentest@ubuntu:~/Desktop$ gcc hello.c -g -o helloDebugSymbols pentest@ubuntu:~/Desktop$ gdb -q ./helloDebugSymbols
Reading symbols from ./helloDebugSymbols...done.
(gdb) info functions
All defined functions: File hello.c:
void main();
Non-debugging symbols:
0x00000000000004e8 _init
0x0000000000000510 puts@plt
0x0000000000000520 __cxa_finalize@plt
0x0000000000000530 _start
0x0000000000000560 deregister_tm_clones
0x00000000000005a0 register_tm_clones
0x00000000000005f0 __do_global_dtors_aux
0x0000000000000630 frame_dummy
0x0000000000000650 __libc_csu_init
0x00000000000006c0 __libc_csu_fini
0x00000000000006c4 _fini
Now we will try the same with Stripped Binary and we can see that as there there is no debug symbols there is no reference to the function void main() as per source code. However there are still certain debug information available. For example I can find the address of main function.
pentest@ubuntu:~/Desktop$ gcc hello.c -o helloNoDebugSymbols pentest@ubuntu:~/Desktop$ gdb -q ./helloNoDebugSymbols
Reading symbols from ./helloNoDebugSymbols...(no debugging symbols found)...done.
(gdb) info functions
All defined functions:
Non-debugging symbols:
0x00000000000004e8 _init
0x0000000000000510 puts@plt
0x0000000000000520 __cxa_finalize@plt
0x0000000000000530 _start
0x0000000000000560 deregister_tm_clones
0x00000000000005a0 register_tm_clones
0x00000000000005f0 __do_global_dtors_aux
0x0000000000000630 frame_dummy
0x000000000000063a main
0x0000000000000650 __libc_csu_init
0x00000000000006c0 __libc_csu_fini
0x00000000000006c4 _fini
We can strip it down further using strip function
pentest@ubuntu:~/Desktop$ strip -s helloNoDebugSymbols -o helloNoDebugSymbolsStripped
pentest@ubuntu:~/Desktop$ gdb -q ./helloNoDebugSymbolsStripped
Reading symbols from ./helloNoDebugSymbolsStripped...(no debugging symbols found)...done.
(gdb) info functions
All defined functions:
Non-debugging symbols:
0x0000000000000510 puts@plt
0x0000000000000520 __cxa_finalize@plt
So that's all for this blog post. In my further posts I will talk in more details about each of the part of elf binary in more details
shellcode a ASM y al reves

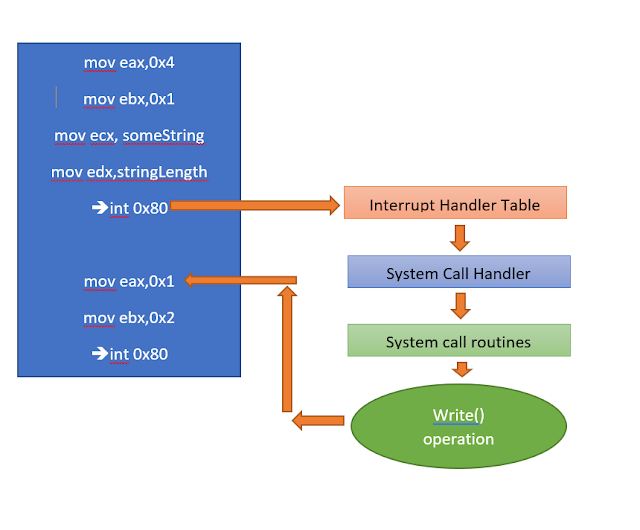
/*Este manual no es de mi autoría. Salió de https://oxhat.blogspot.com*/ As i have started a journey into vulnerability research and exploitation, i thought of sharing some topics which I found very confusing initially. So i will try to detail as much information as possible. So we will begin by writing a simple helloworld assembly code. The code will do the following Print HelloWorld and Exit Now you may wonder why do I have to write a code that exits ? If such is the case then you might probably have written good amount of code in high level language. The compilers of high level languages takes care of it i.e writing the extra code in the object file like the exit code. Internally every operations like read , write , exit and so on requires some low level calls to kernel. These calls are called SysCalls. So if you are programming using high level language like C and C++ , then you don't need to write codes to make the syscalls because due to the abstraction layer that hides the excessive code that is required to code. The compiler takes care to generate the object code which has essential exit code in it. To trigger these syscalls we need to use interrupt. Now these interrupt is maintained using an interrupt table. The diagram below shows the workflow of the syscalls and the interrupt
Now that i have given you a brief idea on why we need to write an exit code in asm, we will program a helloworld code global _start section .text _start: ;/usr/include/i386-linux-gnu/asm/unistd_32.h ;#ifndef _ASM_X86_UNISTD_32_H ;#define _ASM_X86_UNISTD_32_H 1 ;#define __NR_restart_syscall 0 ;#define __NR_exit 1 ;#define __NR_fork 2 ;#define __NR_read 3 ;#define __NR_write 4 ;#define __NR_open 5 ;#define __NR_close 6 ;ssize_t write(int fd, const void *buf, size_t count); mov eax,0x4 ; syscall for write => 4 mov ebx,0x1 ; fd => stdout mov ecx,someString ; *buf => someString mov edx,strlen ; size_t count => strlen int 0x80 ; call interrupt ;void exit(int status); mov eax,0x1 ; syscall for exit => 1 mov ebx,0x2 ; status => 2 int 0x80 ; call innterupt section .data someString: db "Hello World NASM" strlen equ $-someString
Now that I have a working , elf binary , my next target is to generate the shellcode from it. I will use the objdump utility to view the disassembled contents of the binary along with the opcodes.
There is a nice one liner at ( http://www.commandlinefu.com/commands/view/6051/get-all-shellcode-on-binary-file-from-objdump ) which we can use to get the shellcode from the binary. objdump -d ./PROGRAM|grep '[0-9a-f]:'|grep -v 'file'|cut -f2 -d:|cut -f1-6 -d' '|tr -s ' '|tr '\t' ' '|sed 's/ $//g'|sed 's/ /\\x/g'|paste -d '' -s |sed 's/^/"/'|sed 's/$/"/g' Using this technique, we can get a nice shell code from it which we dont need to extract manually from the disassembled code objdump -d ./helloworld|grep '[0-9a-f]:'|grep -v 'file'|cut -f2 -d:|cut -f1-6 -d' '|tr -s ' '|tr '\t' ' '|sed 's/ $//g'|sed 's/ /\\x/g'|paste -d '' -s |sed 's/^/"/'|sed 's/$/"/g' "\xb8\x04\x00\x00\x00\xbb\x01\x00\x00\x00\xb9\xa4\x90\x04\x08\xba\x10\x00\x00\x00\xcd\x80\xb8\x01\x00\x00\x00\xbb\x02\x00\x00\x00\xcd\x80" Sweet! Now our 1st part of the tutorial is over , moving to the next , ShellCode to Assembly. Now if I present you with the following shellcode, how will you get back to a working elf executable. "\xb8\x04\x00\x00\x00\xbb\x01\x00\x00\x00\xb9\xa4\x90\x04\x08\xba\x10\x00\x00\x00\xcd\x80\xb8\x01\x00\x00\x00\xbb\x02\x00\x00\x00\xcd\x80"' Lets copy the shellcode and save the contents inside a file. Please note we are going to save the shellcode as raw hex file and not as text. To do it we need help of perl Syntax : perl -e 'print "YOUR SHELL CODE"' > outputFile perl -e 'print "\xb8\x04\x00\x00\x00\xbb\x01\x00\x00\x00\xb9\xa4\x90\x04\x08\xba\x10\x00\x00\x00\xcd\x80\xb8\x01\x00\x00\x00\xbb\x02\x00\x00\x00\xcd\x80"' > hexraw Now we will use the ndisasm utility to get the disassembled code from the file. So what ndisasm is doing here is converting the hex opcodes into equivalent asm instructions. Syntax : ndisasm -b 32 hexraw
Now you can see , we almost have the same code that we wrote, except there is an hardcoded address 0x80490a4 at line 3 and hardcoded value at line 4. The problem is we got the disassembled code of the .text section and not the .data section. Let us fix the code by modifying the code a little. global _start section .text _start: mov eax,0x4 mov ebx,0x1 mov ecx,someString mov edx,strlen int 0x80 mov eax,0x1 mov ebx,0x2 int 0x80 section .data someString: db "Hello World ASM" strlen equ $-someString Finally we are able to get back our ASM code and make it execute successfully

lunes, 25 de marzo de 2024

conversion explicita (casting)

C++, conversión explícita o cast Cuando necesitamos convertir una variable perteneciente a un tipo de dato (cadena, numérico, fecha, etc.) a otro tipo diferente del suyo original, debemos decirle al programa explícitamente que tipo de conversión deseamos.

La conversión explícita en vez de realizarla el compilador automáticamente se indica de forma explícita, en C++ utilizamos la forma (nombre_de_tipo)expresión. No es exclusiva de C++ pues también se puede emplear en otros programas aunque cambie ligeramente la implementación.

Notación cast Si tenemos una función previamente definida que espera un tipo determinado, por ejemplo la función raíz cuadrada (sqrt) espera como argumento un tipo double, para evitar una salida inesperada en el caso de pasar un argumento de otro tipo, podemos escribir: sqrt ( ( double ) ( n + 2) ); De este modo forzamos para que el resultado de ( n + 2 ) sea siempre un tipo double y se lo pase a la función sqrt.

En C++ es posible expresar también una construcción cast de la forma siguiente: nombre_de_tipo(expresión) esta recibe el nombre de notación funcional, y no se puede utilizar con tipos que tengan un nombre simple.

Notación funcional Para convertir un valor a un tipo puntero utilizando la notación cast escribiríamos: int *p = ( int *)0x1F5; Pero utilizando la notación funcional escribiremo: typedef int *pint; int *p = pint(0x1F5);

Una variable de un determinado tipo no siempre puede ser convertida explícitamente a otro tipo. En este caso: struct { unsigned int a : 3; // bits 0 a 2 unsigned int b : 1; // bit 3 unsigned int c : 3; // bits 4 a 6 unsigned int d : 1; // bit 7 } atributo; La variable atributo tiene una longitud de ocho bits. Pero si intentamnos copiar la variable atributo a una variable atrib de tipo char y escribimos. char atrib = char atributo; // error Da un error, ya que C++ no permite convertir una estructura a un tipo como char aunque las longitudes de ambos sean iguales.

Conversión de Punteros Utilizando conversiones explícitas de tipo sobre punteros, es posible convertir el valor de una variable de un determinado tipo a otro cualquiera. El formato general para hacer esto es: cualquier_tipo *p = ( cualquier_tipo *)&variable. Aplicando esto al caso anterior, obtendríamos: char * atrib = ( char *)&atributo; Con lo que char a = * atrib; define la variable a de tipo char, cuyo contenido es el mismo que el de la estructura atributo. Constructores y operadores de conversión Cuando trabajamos con clases, nosotros mismos tenemos que construir las conversiones que deseamos que realice el compilador cuando utilice un objeto de una clase. Estas conversiones pueden ser o entre una clase y un tipo predefinido. Para ello podemos utilizar dos mecanismos; constructores y operadores de conversión. Constructores Podemos definir una conversión a través de un constructor que tome un argumento de un determinado tipo como entrada y lo convierta en un objeto de una determinada clase. En la definición de una clase podemos definir el siguiente constructor: nombre_de_clase (int r) { real = ( double )r; imag = 0; } Que sirve para construir un número complejo. Este constructor además de inicializar un objeto complejo utilizando solamente un valor también permite asignar directamente un entero int a un objeto complejo como se muestra a continuación. complejo c(3); // construye el complejo (3,0) c = 6; // equivale a c = complejo(6) Operador de conversión Ahora se desea que se realice también de una forma implícita o explícita, si existe ambigüedad, la conversión de un tipo definido por el usuario a un tipo básico: double d; CRacional r(1,2); d = r ; // r tiene que convertirse a double para que la instrucción d = r se ejecute correctamente, es necesario realizar una conversión implícita de CRacional a double. Este tipo de conversión no está permitido con un constructor, ya que no podemos definir un constructor de un tipo base. Cuando necesitamos convertir objetos de un tipo de clase a otro tipo, tenemos que utilizar un operador de conversión. La sintaxis para este operador es: C::operator T(); Donde T es el nombre de un tipo. La conversión que se realiza es de C a T. Para convertir de CRacional a double. class CRacional { //....... operador double(); }; inline CRacional::operator double() { return ( double )numerador/( double )denominador; } Un operador de conversión no puede tener argumentos ni tipo del valor que se retorna. Un operador de conversión se puede llamar de a través de las formas siguientes: double d; CRacional r(1,2); d = r.operator double();/llamada explícita a la función d = double(r);//conversión explícita (notación funcional ) d = ( double )r; //conversión explícita cast d = r ; // conversión implícita Un operador de conversión puede llamarse explícitamente pero su principal utilidad es que sea llamado automáticamente por el compilador cuando la evaluación de una expresión requiere el tipo de conversión realizado por él. También puede definirse un operador de conversión que convierta un objeto de una clase a otro objeto de otra clase. Conversión del tipo void* El tipo void se puede utilizar para definir un puntero a un elemento genérico. Como podemos ver la función C malloc se define como: void *malloc(size_t n); En C, la conversión del tipo void* a otro tipo podía realizarse de forma implícita de este modo. char *p = malloc(longitud + 1); Pero en C++ esta conversión tiene que realizarse de forma explícita. Esto es. char *p = ( char * ) malloc ( longitud + 1 );

punteros,templates(plantillas)

Operaciones con punteros. Tipos genéricos. Plantillas. ( Templates ). Typedef. El operador sizeof. Constructores. Objetos de la clase. Operaciones con punteros El lenguaje C++ ofrece cinco operaciones básicas con punteros. 1- Asignación: Consiste en asignar una dirección a un puntero. Normalmente se empleará el nombre de un array o con el operador dirección (&). En el siguiente ejemplo, se asigna a punt1 la dirección del inicio de un array llamado arr. En la variable punt2 colocamos la dirección del tercer y último elemento, arr[2]. static int arr[] = { 10,20,30}; int *punt1, *punt2; punt1 = arr; // asigna una dirección al puntero punt2 = & arr[2];
2- Valor guardado en una dirección: El operador * nos da el valor almacenado en la posición de memoria apuntada. *punt1 =arr[1]; //obtenemos en *punt1 el valor que hay en arr[1]. 3- Dirección de un puntero: Como cualquier variable, los punteros tienen una dirección y un valor. El operador & nos dice dónde está almacenado el puntero. int direcc; direcc = &punt1; // en direc metemos la dirección en la que se encuentra punt1. 4- Incremento de un puntero: Es posible realizar esta tarea como una suma normal o a través del operador de incremento. Si incrementamos un puntero, éste apuntará al siguiente elemento del array. De este modo, punt1++ incrementa el valor numérico de punt1 en 2 ( un int ocupa 2 bytes ) y hace que punt1 señale a arr[1]. Hay que tener en cuenta que la dirección de punt1 sigue siendo la misma. Pues una variable no se mueve de su sitio sólo por el hecho de cambiar su valor. También es posible decrementar el puntero pero hay que tener en cuenta algunos puntos peligrosos. El ordenador no le sigue la pista a un puntero, por tanto no puede saber si está apuntando dentro de un array o producirá un error. La operación ++punt1 hace que punt1 se mueva otros dos bytes. Otra cuestión a tener en cuenta es que sólo se pueden incrementar variables, y no constantes, así que una constante que sea puntero no puede cambiar su valor ( esto puede parecer una perogrullada, pero ++arr es una expresión muy atractiva). Sin embargo, sí puede utilizarse en esta suma normal. Válido No válido punt1++; arr++; x++; 3++; punt2 = punt1 + 4; punt2 = arr++; punt2 = arr + 1; x = y + 3++; 5- Resta: Dos punteros pueden restarse. Se utilizará con dos punteros que señalen elementos dentro de un mismo array, para saber cuántos elementos les separan. El resultado no son bytes, sino las mismas unidades del tamaño del array. Punteros y arrays En el siguiente ejemplo veremos cómo se relacionan los puntero y los arrays, vamos a ver primero la notación de un array y luego la notación de un puntero. Versión de array: // imprime los valores del array main( ) { static int nums[ ] = { 90, 70, 69, 58 }; int indice; for (indice = 0; indice < 4; indice ++) cout << nums[indice]; } Esta forma de programar es más directa, pues utiliza la notación de array para acceder a los elementos del array mediante la expresión nums[indice]. Versión de punteros: // utiliza punteros para imprimir los valores del array main( ) { static int nums[ ] = { 90, 70, 69, 58 }; int indice; for (indice = 0; indice < 5; indice ++) cout << *(nums + indice); } Esta versión es idéntica a la primera, excepto por la expresión *(nums + indice). Cuyo efecto es exactamente el mismo que el de nums[indice] en el programa anterior, es decir: *( array + indice) es lo mismo que array[indice] Una tira de caracteres es una cadena de bytes, finalizada por el carácter especial '\0'; En este caso para inicializar la cadena, emplearemos: char *saludo = "Hola "; En vez de static char saludo[ ] = "Hola "; Estos dos formatos parecen que tienen el mismo efecto en el programa. Pero hay una pequeña diferencia. La segunda línea reserva espacio para un array con el suficiente número de bytes ( En este caso 10 ) para almacenar la palabra más un byte correspondiente al carácter '\0' ( nulo ). La dirección del primer carácter del array se obtiene dando el nombre del array, saludo. En la versión puntero (la primera línea) se reserva espacio para el array de la misma forma, pero también se reserva espacio para una variable de puntero, este puntero es el que recibe el nombre saludo. Tipos genéricos. Plantillas. ( Templates ) Los tipos genéricos o tipos parametrizados, también denominados plantillas, permiten construir una familia de funciones o clases relacionadas. Las funciones o clases se diseñan para trabajar con un tipo específico de datos. Esta característica tiene poco interés para el diseñador de la función o de la clase, pero tiene importancia para el usuario de la función o clase, ya que le permitiría elegir el tipo de datos que necesite en cada momento. Las funciones genéricas o plantillas de función admiten argumentos de cualquier tipo. Es decir podemos definir una plantilla que admita el tipo como un parámetro más. #include template < class Plantilla > Plantilla min(Plantilla a, Plantilla b) { return ( a < b ) ? a : b; } void main( ) { int m = 11, n = 28; float x = 17.5, y = 36.2; cout << min ( m, n) << endl; cout << min (x, y) << endl; } Una plantilla no es una definición de función, sino un patrón a partir del cual el compilador puede generar una función. El prefijo template < class Plantilla > indicará al compilador que Plantilla se proporcionará en el momento de la expansión de la plantilla a una definición real de la función, en ese momento un tipo definido sustituirá a Plantilla. Si necesitamos que a sea de un tipo cualquiera y b de otro tipo cualquiera. Entonces escribimos: #include < iostream.h> template < class Plantilla1, class Plantilla2 > Plantilla2 min (Plantilla 2 a, Plantilla1 b) { return ( a < b ) ? a : b; } void main( ) { int m = 11, n = 28; float x = 17.5, y = 36.2; cout << min ( m, n) << endl; cout << min ( x, n) << endl; cout << min ( m, y) << endl; cout << min ( x, y) << endl; } El prefijo template < class Plantilla1, class Plantilla2 > indica que la plantilla en el momento de la expansión sustituirá Plantilla1 y Plantilla2 por los argumentos correspondientes a los tipos en la llamada a min, El compilador expandirá la plantilla automáticamente cuando sea necesario. Por ejemplo, si detecta una llamada min con dos argumentos enteros, automáticamente amplía una versión int de la plantilla. Clases genéricas Aunque las plantillas son útiles, son aún más importantes las plantillas de clase. Las clases genéricas o plantillas de clase permitirán definir un patrón para definiciones de clases. Las clases contenedor o clases de contenido; esto es, una clase que contiene objetos del mismo tipo (listas, arrays, etc). Son buenos ejemplos de plantillas. Si tenemos un vector de enteros o de cualquier tipo, las operaciones básicas que podremos realizar con él, serán las mismas (insertar, borrar, leer, etc.). Lo que permitirá al usuario elegir el tipo de elementos del array, para ellos, definiremos una clase genérica. Una plantilla de clase se diferencia de una plantilla de función por que se expande, dando lugar a una definición completa de clase, cuyos tipos internos son proporcionados por el usuario. Las funciones que son miembros de la plantilla de clase, también son plantillas de función, y por tanto, también tendrán que expandirse cada vez que se expanda la clase asociada. La solución a este problema, y por tanto la forma correcta de utilizar las plantillas, consiste en reunir en una sola clase base común todo el código que podría ser idéntico en las diversas ampliaciones de la plantilla, y derivar de ella la plantilla de clase. Typedef La palabra clave typedef crea un tipo al que se le asigna un nombre arbitrario dado por el programador. Se parece a #define, pero tiene tres diferencias: 1. typedef está limitado a asignar nombres simbólicos a tipos de datos únicamente, al contrario de como hace #define 2. La función typedef se ejecuta desde el compilador y desde el preprocesador. 3. Dentro de sus límites, typedef es más flexible que #define. typedef float real; ó typedef float REAL; permite declaraciones del tipo: real x; ó REAL *numero; También es posible el uso de typedef con estructuras: typedef struct DAT_PER{ char nombre[25]; union datos_conf{ char matricula[20]; int cuenta; char nif; } conf; DAT_PER *sig; }personal[MAX_NUM_PERSONAS]; lo cual permite declaraciones más intelegibles: DAT_PER *sig; o DAT_PER personal[MAX_NUM_PERSONAS] Operador sizeof El operador sizeof no se representa mediante un símbolo como el resto de operadores. Es un operador unario, no una función. Devuelve el tamaño en bytes de un objeto determinado. La forma de utilizar sizeof es: sizeof expresión; Donde expresión es el nombre de una variable o de un tipo de datos. El objetivo de sizeof es determinar el tamaño de varios objetos dependientes de la máquina. Es muy útil para escribir programas que puedan ejecutarse en varios tipos de ordenadores. Pues estos pueden tener tamaños de almacenamiento diferentes. //muestra el tamaño en bytes de varios tipos de datos main( ) { cout << sizeof(char); cout << sizeof(short); cout << sizeof(int); cout << sizeof(long); cout << sizeof(float); cout << sizeof(double); } Este ejemplo devuelve la memoria se se usa para cada dato de tipo primario. Si se ejecuta en un sistema de 16 bits. El programa le dirá que un entero ocupa 4 bytes. En uno de 64 bits le dirá que ocupa 8 bytes. Un programa que necesite este tipo de información se puede obtener fácilmente utilizando sizeof. Constructores. Objetos de la clase En primer lugar definimos una clase: class Punto{ int x; // miembros dato int y; char ch; public: void mostrar( ); void ocultar( ); }; void Punto::mostrar( ) { gotoxy( x, y); cout << ch; } void Punto::ocultar( ) { gotoxy( x, y); cout << " "; } Una vez definida la clase, para usarla se ha de definir un objeto. Se define una variable de la clase Punto, exactamente igual que se define una variable de un tipo predefinido ( int, float, etc,) o cualquier otro tipo definido por el usuario. Los objetos usan la misma notación que cualquier tipo de variable, y su alcance se extiende desde la línea donde se ha declarado hasta el final del bloque. Para crear un objeto de una clase se llama a una función denominada constructor. El constructor se llama de forma automática cuando se crea un objeto. El constructor tiene el mismo nombre que la clase. Lo específico del constructor es que no tiene tipo de retorno. Punto::Punto(argumentos) -Declaración del constructor class Punto { //... public: Punto ( char ch1, int x1, int y1); }; - El constructor inicializa los miembros dato en la definición del constructor. Punto::Punto ( char ch1, int x1, int y1) { ch = ch1; x = x1; y = y1; } -Llamamos al constructor. Para crear un objeto pt1 de la clase Punto. Punto pt1('*',20,33); En el objeto, el miembro dato ch guardará el carácter *, el miembro dato x, el número entero 20, y el miembro y, el entero 33. -Se llama a las funciones miembro desde el objeto pt1 pt1.mostrar( ); pt1.ocultar( ); Es posible tener más de un constructor, A continuación definimos uno que fije el carácter pero que permita cambiar las coordenadas del punto. -Declaración de constructor class Punto{ //... public: Punto( int x1, int y1); //... }; -Definición del constructor: se fija el carácter, y se le pasan las coordenadas del punto Punto::Punto( int x1, int y1 ) { x = x1; y = y1; ch = '*'; } Se llama al constructor para crear un objeto pt2 Punto pt2( 20, 33 ); En el objeto, el miembro dato ch almacenará el carácter *, el miembro dato x, el número entero 20, y el miembro y el entero 33. -Se llama a las funciones miembro desde el objeto pt2 pt2.mostrar( ); pt2.ocultar( ); Una clase puede tener más de un constructor. Si un constructor no tiene argumentos, es el constructor por defecto. -Declaración del constructor por defecto de la clase class Punto{ //... public: Punto( ); //... }; -Definición del constructor por defecto: los miembros dato se inicializan en el bloque de dicho constructor Punto::Punto( ) { ch = '*'; x = 20; y = 33; } Para llamar al constructor por defecto escribimos: Punto def; Si escribimos Punto def( ); // error Da un error. Para llamar a las funciones miembro desde el objeto def. def.mostrar( ); def.ocultar( );

puntero implicito this, keyword friend

El puntero implícito this Saltar el sistema de protección. ( Friend ) Miembros static de una clase Funciones virtuales El puntero implícito this Cada objeto de una determinada clase mantiene su propia copia de los datos miembro de la clase, pero no de las funciones miembro, de estas sólo existe una copia para todos los objetos de la clase; es decir, cada objeto tiene su propia estructura de datos, pero todos comparten el mismo código para cada función miembro. De este modo si necesitamos que una función miembro conozca la identidad de cada objeto para el que ha sido llamada, en C++ debemos invocar un puntero al objeto denominado this. Así por ejemplo, si declaramos un objeto. Empleado.set_empleado( ); C++ define el puntero this para apuntar al objeto fecha1 de la forma: CEmpleado *const this = &Empleado1; y si realizamos la misma operación con otro objeto empleado2, empleado2.set_empleado( ); C++ define el puntero this, para apuntar al objeto empleado2, de la forma: CEmpleado *const this = &Empleado2; Según lo expuesto, la función set_empleado puede ser definida de la forma: void CEmpleado::set_empleado( ) { cout << "nombre, ## : "; cstr >> this->nombre; cout << "apellido1, ## : "; cstr >> this ->apellido1; cout << "apellido2, #### :"; cstr >> this -> apellido2; } Un ejemplo de esto. do empleado.set_empleado( ); while ( !empleado.ok_empleado( )); En este caso, la función miembro ok_empleado conoce con exactitud a que objeto ha de ser aplicada, puesto que se ha expresado explícitamente. Pero ¿Que pasa con la función miembro Jefe_de, que se encuentra sin referencia directa alguna en el cuerpo de la función miembro ok_empleado? int Cempleado::ok_empleado( ) { //... if (Jefe_de (apellido1)) //... } En este otro caso la llamada no es explícita como en el anterior. Lo que sucede realmente, es que todas las llamadas a los datos y funciones miembro son referenciadas con un puntero implícito this, que contiene, como ya se ha dicho, la dirección del objeto por medio del cual se ha producido la llamada. Según esto también podríamos escribir. if ( this -> Jefe_de(apellido1 )); Normalmente no será necesario utilizar este puntero para acceder a los miembros de la clase, pero es útil cuando si se trabaja con estructuras dinámicas, también se puede utilizar la expresión (*this) miembro. Saltar el sistema de protección. (Friend) Los datos miembro de una clase declarados en la parte privada pueden manipularse únicamente por las funciones miembro de la clase, este es el modo de garantizar su integridad. El resultado es como una caja negra que realiza cierta función y que es reutilizable en cualquier otro programa. En el caso de que una función no miembro de una determinada clase necesite acceder a los datos miembro privados de la misma, hay que declarar a dicha función amiga de la clase. Para esto se declara la función anteponiendo al nombre de la misma la palabra reservada friend. Una función declarada friend de una clase CClase es una función no miembro que puede acceder a los miembros privados de la clase CClase. Por ejemplo la función VisualizarVector de CClase no puede acceder a la clase CVector. Según lo expuesto este problema puede resolverse haciendo que la función VisualizarVector sea friend de la clase CVector esto es: class CClase { void VisualizarVector( CVector &objvector); }; class CVector { friend void VisualizarVector( CVector &objvector); //... }; De este modo la definición de la función VisualizarVector puede utilizar datos miembro declarados como private en la clase CVector. Una función friend se puede declarar en cualquier sección de la clase. class C1; // declaración class C2 { public: int GetDato ( C1 &obj); //... }; class C1 { friend int C2::GetDato( C1 &); //... }; Algunas veces puede ser también necesario que una clase C1 tenga acceso directo a los datos miembro privados de otra clase C2. class C1 { friend class C2; //... }; Jerarquía de clases con Friend Una función friend de una clase base puede acceder solamente a los miembros de la clase derivada que fueron heredados de la clase base. Es decir, la amistad no se hereda. Si la función es friend de la clase derivada, esta puede acceder a los miembros públicos y protegidos de la clase base. Una clase friend de una clase base tiene acceso, además de a los miembros públicos, a los miembros privados y protegidos de la clase base, pero no tiene acceso a los miembros privados y protegidos de la clase derivada. Sin embargo, una clase friend de una clase derivada de una clase base, no tiene acceso a los miembros privados y protegidos de dicha clase base. Esto indica que no hay una relación entre ambas clases friend. Miembros static de una clase Una clase es un tipo, no un objeto (Un objeto es un ejemplar de una clase determinada) cada objeto de una determinada clase tiene su propia copia de los datos miembro de la clase a la que pertenece, pero no de las funciones miembro. Si declaramos un dato miembro de una clase como static, sólo existirá una copia de ese miembro, la cual será compartida por todos los objetos de esa clase y existirá aunque no existan objetos de esa clase. Un dato miembro de una clase declarado como static es una variable asociada con la clase, no con el objeto. Un dato miembro static existirá aunque no se hayan declarado objetos de la clase. Un dato miembro static debe ser declarado a nivel global. No se debe colocar la inicialización en un lugar donde se pueda producir más de una vez; por ejemplo, en un fichero de cabecera, ya que este puede ser cargado más de una vez. La inicialización de un dato static normalmente se colocará en el fichero fuente que contiene las definiciones de las funciones miembros de la clase. class CCuenta { //... static float Saldo; }; // inicializar variables estáticas float CCuenta::Saldo = 15,34; //... Una función miembro declarada como static podrá acceder solamente a miembros static de su propia clase. Este tipo de funciones no estarán asociadas con un objeto específico. Por lo que no tiene puntero this, y esto impide que puedan acceder a un miembro normal de su clase. Estas funciones se utilizan normalmente para actuar globalmente sobre todos los objetos de una clase. class CCuenta { //... static void SetSaldo ( float NuevoSaldo) { Saldo = NuevoSaldo;} //... static float Saldo; }; // inicializar variables estáticas float CCuenta::Saldo = 15,34; void main ( ) { //... CCuenta::SetSaldo (20); //... } Una función miembro static también puede llamarse utilizando la siguiente sintaxis: nombre_objeto.SetSaldo(20); Pero resulta engañosa ya que su acción no se ejecutará sobre un objeto en particular, sino sobre todos los objetos de la clase. En definitiva, un miembro static de una clase no está asociado con un objeto individual de la clase, sino que lo está con la propia clase. Funciones virtuales Si se llama a una función miembro que está definida en la clase base y también está definida en la clase derivada, la función que realmente es invocada dependerá del tipo de objeto o del puntero que se utilice para invocar a la misma. Si llamamos a una función que se define con el mismo nombre en varias clases, necesitamos que la función llamada pertenezca a la misma clase que el objeto referenciado. Cuando se llama a una función miembro que está definida en la clase base y en la clase derivada, la función invocada depende del tipo de puntero. El propio sistema será el que se encargue de identificar en tiempo de ejecución la clase de los objetos apuntados. El mecanismo que utiliza C++ para esto es la función virtual. Una función virtual es pues una función miembro pública o protegida de una clase base que puede ser redefinida en cada una de las clases derivadas. Una vez redefinida se accede a ella a través de un puntero o una referencia a su clase base. Para declarar una función virtual hay que colocar la palabra clave virtual antes de la declaración de la función miembro de la clase base. Las redefiniciones que realicemos de esta función en las clases derivadas no necesitan incorporar en su declaración la palabra clave virtual; serán declaradas implícitamente. class Albaran { //... virtual void Visualizar( ); //... }; La declaración de la función visualizar en la clase base le precede la palabra clave virtual. De este modo, tanto la función Visualizar de la clase base como la de las clases derivadas serán funciones virtuales. Una función global o static no podrá ser declarada virtual, ya que una función virtual sólo será llamada para objetos de su clase. Pero, una función virtual si podrá ser declarada friend de otra clase. Llamar a una función virtual La sintaxis para llamar a una función virtual es la misma que se utiliza para llamar a una función miembro normal. Una función virtual será invocada mediante una referencia o puntero a su clase base. La llamada a través de un puntero será automáticamente manipulada dependiendo del tipo del objeto apuntado. Si la llamada a la función virtual se hace a través de un objeto de una clase, el compilador resolverá la función a invocar basándose en el tipo de objeto. Como regla general una llamada a una función virtual se resolverá en función del tipo de objeto para el que es invocada, mientras que una llamada a una función no virtual se resolverá en base al tipo de puntero o de la referencia. Redefinición de una función virtual Una función virtual en una clase base continúa siendo virtual cuando es heredada. Una clase derivada puede disponer de su propia versión de la función virtual o asumirla tal cual. Cuando la clase derivada provee de su propia versión, no será necesario volver a especificar la palabra clave virtual. Una clase derivada también puede contener sus propias funciones virtuales; es decir, funciones virtuales propias y no heredadas de sus clases base. Para redefinir una función virtual en una clase derivada, dicha función debe tener el mismo nombre, número de tipos de argumentos y mismo tipo del valor retornado que la definida en la clase base. Si la redefinición difiere en el tipo del valor retornado, se producirá un error. Por otra parte, si difiere en los argumentos, la función será tratada como una función sobrecargada. Cuando en una clase base derivada se redefine una función de una clase base, se oculta la función de la clase base y todas las sobrecargadas de la misma en la clase base. Constructores y destructores virtuales C++ no admite constructores virtuales por tanto si un constructor llama a una función virtual, ésta corresponderá a la clase base, ya que todavía no se ha creado el objeto de la clase derivada. Si una clase base y sus derivadas tienen definidos sus destructores. Cuando durante la ejecución se sale fuera del ámbito del objeto de una clase derivada, se llamará primero al destructor de esa clase derivada y después al destructor de su clase base. Pero si el objeto ha sido creado dinámicamente y está referenciado por un puntero a la clase base, surge un problema, pues cuando se aplique el operador delete, el compilador llamará al destructor de la base aunque el objeto referenciado sea de una clase derivada. Para solucionar esto se debe declarar un destructor virtual, pero esto hace que todos los destructores de todas las clases derivadas sean virtuales, aunque no compartan el mismo nombre que el destructor de la clase base. De esta forma, cuando se aplica delete a un puntero de la clase base, este llamará al destructor perteneciente a la clase del objeto apuntado. Una buena práctica será colocar un destructor virtual a una clase que posea funciones virtuales, aunque este destructor no haga nada. El motivo de esto es que una clase derivada puede requerir un destructor; por ejemplo, si se deriva una clase de una clase base que define un destructor para ella. Colocando un destructor virtual en la clase base, nos aseguramos de que el destructor de la clase derivada será llamado cuando se necesite. Cómo se implementan las funciones virtuales El compilador no puede identificar durante la compilación la función que va a ser llamada por una sentencia como volumen[i]->Visualizar( ), ya que podría ser cualquiera de varias funciones diferentes. Esto pasa si la función Visualizar se declara virtual en la clase, esto hace que también sea virtual en todas las clases derivadas donde esté definida. El compilador evalúa la sentencia en tiempo de ejecución; es decir, cuando puede indicarle a qué tipo de objeto apunta Volumen[i]. Esto se conoce como asociación dinámica o asociación retrasada. En OOP decimos que un mensaje dirigido a un objeto se asocia con un método. Cuando la asociación se hace durante la compilación, se denomina asociación estática. Y cuando se hace durante la ejecución se llama asociación dinámica. La asociación dinámica sucede si el método que se asocia está definido como virtual. El compilador utilizará la asociación dinámica cuando no se puede utilizar una asociación estática, como ocurre a continuación: void CBiblioteca::VisualizarVol( ) { if (NVols > 0) for ( int i = 0; i < NVols; i ++) { Volumen[i] -> Visualizar( ); cout << endl; } } La asociación dinámica en C++ se implementa a través de una tabla de funciones virtuales o v-table. Dicha tabla está formada por un array de punteros a funciones que el compilador asocia a cada una de las clases que contienen una o más funciones virtuales. La v-table contiene un puntero a una función por cada una de las funciones virtuales de la clase. Clases abstractas y funciones virtuales puras En este blog ya se habló de clases abstractas en VB.Net como se dijo, una clase abstracta es una clase que puede utilizarse solamente como clase base para otras clases. Se trata de disponer de un mecanismo que soporte la implementación de un concepto general, como figura, del cual utilizaremos variantes concretas, cómo círculo, cuadrado y triángulo o como se explicó en .net con las piezas de ajedrez. Pensando en estas ideas,abstractas no se pueden crear objetos de una clase abstracta; lo que crearemos serán objetos de sus clase derivadas. Una clase para ser abstracta, necesita tener al menos una función virtual pura. Por ejemplo. class CPieza // clase abstracta { //... virtual void Visualizar( ) const = 0; //función virtual pura //... }; Una función virtual pura no requiere definición; es decir, no es necesario escribir el cuerpo de la función. El propósito de una declaración en la clase base es proveer a las clases derivadas de una interfaz polimórfica. Una clase derivada debe proveer una redefinición de la función virtual. Si no se hace, heredará la función virtual pura y se convertirá en una clase abstracta, pero esto no permitirá declarar objetos de la misma. Aunque visualizar se ha declarado constante (const) esto no quiere decir que sea necesario. Si se añade const, a las declaraciones y definiciones en las clases derivadas se tiene que añadir también const. No se pueden crear objetos de una clase abstracta. Si se intenta, el compilador muestra un error. Esta restricción es para prevenir cualquier llamada de un objeto a la función virtual pura. CPieza obj; // error, clase abstracta. Es posible declarar punteros y referencias a una clase abstracta, pero una clase abstracta no se puede utilizar como tipo para un argumento ni como tipo retornado por una función por una función, ni en una conversión cast. Por ejemplo. CPieza *p; // correcto CPieza &fn( CPieza &); // correcto Clases virtuales La jerarquía de clases ocasiona un problema por la derivación múltiple, la clase derivada heredará dos veces los miembros de la clase base. Por tanto cuando se crea un objeto de la clase derivada, éste contendrá dos sub objetos de la clase base. Tener dos sub objetos además de un derroche de espacio, hace que el compilador no sepa cual utilizar y genera un error. Para asegurarnos de que sólo se utiliza un sub objeto de la "clase base indirecta". Es necesario declarar la clase base común virtual cuando se está derivando en las clases base directas. class CBase // clase base { // lista de miembros }; class CDerivada1 : virtual public CBase { // lista de miembros }; class CDerivara2 : virtual public CBase { // lista de miembros }; class CDerivada12 : public CDerivada1, public CDerivada2 { // lista de miembros }; La palabra clave virtual, cuando se están derivando las clases bases directas CDerivada1 y CDerivada2, asegura que el compilador solamente pasará a la clase CDerivada12 una copia de CBase. Los constructores de una clase base virtual serán siempre llamados antes que los constructores de las clases no virtuales, y los destructores son siempre serán llamados en el orden inverso.

funciones sobrecargadas, referencias

/*Este texto no es mío. Viene de analisisyprogramacionoop.blogspot.com*/ Funciones sobrecargadasPaso de parámetros por referenciaReferencia como valor retornadoClases con miembros que son punterosArrays de objetos y de punteros a objetosPunteros a miembros de una clasePunteros como argumentos de funciones Funciones sobrecargadas Se dice que una función está sobrecargada cuando se declara una función previamente declarada con distinto número y/o tipo de parámetros pero con el mismo nombre. Es un concepto de programación orientada a objetos llamado polimorfismo. (Muchas declaraciones de una misma función). Cada función suele tener un nombre que la distingue de las demás. Pero se pueden presentar casos en los que varias funciones ejecuten la misma tarea sobre objetos de diferentes tipos, y puede ser interesante que dichas funciones tengan el mismo nombre. Por ejemplo podemos definir una función Mover para cada tipo de movimiento de una pieza distinta de ajedrez y llamar a todas las funciones con el nombre mover pero distinguirlas por el número y/o el tipo de los parámetros sean diferentes. Otro ejemplo: una función pot que calcule xy siendo x e y enteros o reales podemos hacer. int pot (int, int); double pot (double, double); double pot (int, double); double pot (double, int); El compilador buscará la función adecuada en función del tipo de parámetros que le enviamos, en caso de no encontrar una función con los mismos tipos de argumentos, realizaría las conversiones permitidas sobre los parámetros actuales, buscando así una función. No se pueden declarar dos funciones que difieran solamente en el resultado de salida. En el siguiente código se utilizan una u otra de estas funciones para calcular xy en función de los argumentos pasados en la llamada. #include #include "pot.h" void main( ) { double ad = 2.5 , bd = 1.5; int ai = 3, bi = 2; cout << pot ( ai, bi ) << endl; cout << pot ( ad, bd ) << endl; cout << pot (ai, bd ) << endl; cout << pot (ad, bi) << endl; } Paso de parámetros por referencia Cuando pasamos parámetros por valor se hace una copia de los parámetros en sus correspondientes parámetros formales. Esta operación se hace automáticamente cuando se llama a una función, esto impide que se modifiquen los parámetros actuales. Pasar parámetros por referencia, significa que no se transfieren los valores sino las direcciones de las variables donde están contenidos esos valores, de este modo los parámetros actuales se verán modificados en el mismo valor que lo hagan sus correspondientes parámetros formales. Cuando se llama a una función, los argumentos especificados en la llamada son pasados por valor, excepto si se trata de arrays, donde se pasan por referencia, ya que el nombre del array es un puntero a dicho array. Por valor se pueden traspasar constantes, variables y expresiones, y utilizando la forma de pasar parámetros por referencia solamente se permite transferir las direcciones de variables de cualquier tipo, arrays y funciones. Para pasar una variable por referencia, se pueden utilizar las dos formas explicadas a continuación: 1. Pasar la dirección del parámetro actual a su correspondiente parámetro el cual necesariamente tiene que ser un puntero. void permutar(int *, int *); void main( ) { int a = 10, b = 15; permutar(&a, &b);// se pasan las direcciones de //a y b cout << "a = "<< a << "b = " << b << endl; } // utilizando punteros void permutar( int *x, int *y) { int z = *x; *x = *y; *y = z; } 2. Definir el parámetro como una referencia al parámetro actual que se quiere pasar por referencia. Para ello, es necesario anteponer el operador & al nombre del parámetro. #include void permutar (int &, int &); void main( ) { int a = 10, b = 15; permutar (a, b); cout << " a = " << a << " b= " << b << endl; } // Utilizando referencias x e y son referencias a sus // correspondientes parámetros actuales a y b. void permutar(int &x, int &y) { int z = x; x = y; y = z; } Los resultados son los mismos que en el programa anterior. En el programa con punteros, cualquier asignación que se haga a *x afecta a la variable a. En el programa con referencias, la referencia x también tiene esa propiedad, pero sin necesitar el operador de indirección *. Hay que tener en cuenta que las referencias no pueden manipularse igual que los punteros. Con un puntero se puede distinguir el puntero de la variable apuntada utilizando el operador de indirección *. Es decir, x describe el puntero, mientras que *x describe el dato apuntado. Pero con una referencia sólo podemos referirnos al dato. Cualquier operación sobre la propia referencia se realizará sobre el dato referenciado pero nunca sobre la referencia. Referencia como valor retornado También es posible definir una función en la que el valor devuelto venga dado por una referencia a ese valor. #include int &fnx( ); int n; void main( ) { int c; fnx( ) = 25; // n = 15 c = fnx( ); // c = 15 fnx( )++ ; //n = 16 fnx( ) = fnx( ) + 3; // n =19 } //El tipo del resultado es una referencia a un int int &fnx( ) { // otro código return n; } En este código, el valor retornado por la función fnx es una referencia inicializada con la variable global n. Lo que sucede es que fnx actúa como un nombre alternativo para n. Por tanto una llamada a la función puede aparecer a la izquierda o a la derecha de un operador de asignación. Clases con miembros que son punteros Los operadores new y delete se pueden utilizar en la definición de las funciones miembro de una clase. En el código mostrado debajo, nuestro objetivo es crear un array de enteros con un número cualquiera de elementos. En este caso es inapropiado definir como miembro privado de la clase CVector un array con un número fijo de elementos. Para ello es mejor definir un puntero, pVector, que apunte a un entero para después reservar dinámicamente la cantidad de memoria necesaria para el array. class CVector { public: CVector( ); //crea un array con un nº de elementos //por defecto CVector(int ne); // crea un array de ne elementos CVector(CVector &); // inicialización con un //vector v CVector(int [ ], int ); // inicialización con un //array a // otras funciones miembro private: int *pVector; // puntero base int n_elementos; // numero de elementos }; Una clase cuyos miembros sean de tipo puntero como es CVector puede tener problemas. En el caso de que en el programa anterior no se defina un constructor copia y que la función main sea como esta: void main( ) { CVector vector1(x,7); fnEscribir(vector1); // escribe 1 2 3 4 5 6 7 // el siguiente bloque define vector2 { CVector vector2 = vector1; fnEscribir(vector2); //escribe1 2 3 4 5 6 7 } // vector2 ha sido destruido int *pi = new int[5]; for (int i = 0; i < 5; i++) pi[i] = i * 10; // pi apunta a un array de valores 0 10 20 30 40 fnEscribir(vector1); //escribe 0 10 20 30 40 50 } En el caso de que en el programa anterior no definamos un constructor copia, el constructor copia definido por defecto será de la forma. CVector::CVector(CVector &v) // constructor copia { n_elementos = v.n_elementos; pVector = v.pVector; } Ahora v.pVector es un puntero. El resultado de esta asignación es que pVector y v.pVector apuntan a la misma dirección de memoria. Por tanto cuando ejecutemos el código: CVector vector2 = vector1; // llama al constructor copia El miembro pVector de vector1 y el miembro pVector de vector2 apuntarán al mismo array de enteros. Por lo que cualquier modificación en uno de los objetos afecta a ambos. Si salimos fuera del ámbito de vector2 se llama al destructor de la clase CVector y se liberan los dos bloques de memoria correspondientes a ese objeto ( su estructura interna y el array de objetos ). De este modo cualquier operación posterior con el objeto vector1 podría dar resultados inesperados, ya que pVector de vector1 apuntaba a la misma localización de memoria y ésta ha sido liberada. Por otra parte cuando se sale fuera del ámbito de vector1 se invoca de nuevo al destructor, y este intentará liberar de nuevo el bloque de memoria ocupado por el array de enteros, esto provocará resultados inesperados. En la función main anterior al destruir el vector2, la siguiente instrucción asigna memoria para un array de enteros irreferenciado por pi. Se da la circunstancia de que la memoria asignada ha coincidido con la liberada. Pero en el vector1, además de no tener memoria asignada para su array de enteros, tampoco devuelve los resultados esperados. Esto pone de manifiesto que la memoria se libera, pero los punteros conservan sus valores. Si nuestra intención no fuera esta, sino crear un nuevo array para cada objeto, el constructor debería ser como el que sigue a continuación. CVector::CVector(CVector &v) //constructor copia { n_elementos = v.n_elementos; pVector = new int [n_elementos]; for ( int i = 0; i*. El operador .* liga su segundo operando a su primer operando, el cual debe ser un puntero a un miembro, el cual que debe ser un objeto. En este caso tenemos: objeto.*puntero_a_miembro Es decir. CCalificacion Alumno; float n = Alumno.*pmCalificacion; Si el primer operando es un puntero a un objeto, entonces utilizaremos el operador ->*. La sintaxis será: puntero_a_objeto ->* puntero_a_miembro De este modo temenos. CCalificacion *pAlumno; //... (pAlumno ->*pmfnSetCalificacion)(n); La precedencia de los paréntesis ( ) es mayor que la de .* y ->*, por eso son necesarios. No es posible definir un puntero a un miembro declarado como static, ya que este pertenece a la clase misma y no a un objeto en particular de la clase. Punteros como argumentos de funciones Un buen motivo para pasar un puntero a una función en vez de pasarle una copia del valor de la variable es ahorrar tiempo y espacio. Al pasar una copia de una variable grande, como un array o una estructura de datos grande, requiere una gran cantidad de espacio en la pila y de tiempo. Se puede mejorar el rendimiento de un programa pasando la dirección de esa variable y permitir que la función acceda a sus elementos a través de un puntero. Otro motivo para usar punteros como parámetros es para que una función devuelva más de un sólo valor. Pues una función sólo puede devolver un valor por medio de su sentencia return. Pero si se utilizan parámetros de tipo puntero, se puede dar a la función acceso (y de este modo poder cambiar) los valores de una variable. Para ello, la función llamada tendrá que parar argumentos como una dirección en lugar de como un valor.

const,volatile,inline,new,delete

/*Este texto no es de mi autoría. Fue sacado de analisisyprogramacionoop*/ Declaración de Constantes, const y volatile.Funciones inline.Operadores New y Delete. Declaración de constantes Una constante es como una variable pero como su nombre indica, no varía si no que es constante. Se usa fundamentalmente para definir valores que serán constantes a lo largo de todo el programa pero en vez de poner el mismo valor una y otra vez a lo largo del código, lo definimos sólo una vez al principio, de este modo si hubiera que cambiar dicho valor no es necesario rastrear todo el código buscando donde cambiarlo, basta con cambiar el valor de la constante definida al principio. Esto es válido para cualquier lenguaje aunque los ejemplos se pongan para C++. Calificador const Se puede anteponer el especificador const a la declaración de cualquier objeto o tipo de datos, con el fin de hacer que el objeto sea en lugar de una variable, una constante. const int k = 12; const int v[v] = { 1,2,3,4 }; A un objeto declarado como constante no se le puede asignar un valor más que al principio en su declaración. Al declararlo si una constante k ha sido declarada como constante las siguientes sentencias darían error: k = 100; // error k++; // error Si declaramos un puntero precedido por const, esto hace que el objeto apuntado sea una constante. Pero no pasa lo mismo con el puntero. const char *pc = "abcd"; pc[0] = 'z' ; // error pc = "efg"; // correcto Si en lugar de esto queremos declarar un puntero como una constante, procederíamos así. char *const pc = "abcd"; pc[0] = 'z'; // correcto pc = " efg"; // error Para hacer que tanto el puntero como el objeto apuntado sean constantes, procederemos como se indica a continuación: const char *const pc = "abcd"; pc[0] = 'z'; //error pc = "efg"; // error Una variable global declarada como const se considera static. Calificador volatile Si anteponemos el calificador volatile a la declaración de un objeto, hacemos que dicho objeto pueda ser modificado por otros procesos diferentes al programa actual. Una utilidad del calificador volatile es proveer acceso a las posiciones de memoria utilizadas por procesos asíncronos, tal como manejadores de interrupciones. Los calificadores const y volatile pueden utilizarse conjuntamente o individualmente. volatile int v; Los objetos declarados volátiles no se pueden utilizar en optimizaciones porque sus valores pueden cambiar en cualquier momento. Cada vez que accedemos a un objeto volatile, el sistema lee su valor actual. Además en una asignación, su valor es escrito inmediatamente. Cuando se declara explícitamente un objeto volatile, es un error que la función miembro invocada por este objeto no sea también volatile. Funciones en línea C++ provee el especificador de función llamado inline que cuando precede al nombre de la función hace que el compilador reemplace cualquier llamada a la función por el cuerpo actual de la función. Para utilizar esta funcionalidad, la función debe estar definida antes de ser invocada, en caso contrario, el compilador no la expandirá. Debido a esta restricción, las funciones inline son normalmente definidas en ficheros de cabecera .h. Una función como inline solamente es una recomendación para el compilador. Es decir, el compilador puede tomar la iniciativa de expandir o no la función, por ejemplo, por ser demasiado larga. Las funciones inline son similares a las macros declaradas con #define. Pero es mejor utilizar funciones inline que macros, ya que sus parámetros son chequeados automáticamente y no presentan los problemas de las macros parametrizadas. //Comparación de una función en línea con una macro. #include #define MENOR (X, Y) ((X) < (Y)) ? (X) : (Y) inline int menor ( int x, int y) { return ((x < y) ? x : y); } void main() { int m, a = 20, b = 30; m = MENOR ( a--, b--); // efecto colateral. El valor menor //se decrementa dos veces cout << "menor = " << m; cout << " a = " << a << " b = " << b << endl; a = 20; b = 30; m = menor(a--, b--); cout << " menor = " << m; cout << "a = " << a << " b = " << b << endl; } Este ejemplo da lugar al siguiente resultado: menor = 9 a = 8 b = 19 menor = 10 a = 9 b = 19 Las funciones inline se ejecutan más rápidamente, ya que se evitan las llamadas a cada una de estas funciones. Sin embargo, el abuso de inline en ocasiones puede no ser bueno. Ya que la modificación de una función inline obligaría a recompilar todos los módulos en los que ésta apareciera. Además el tamaño del código puede aumentar extraordinariamente. Se recomienda utilizar solamente el especificador inline cuando la función es muy pequeña o si se llama desde pocos lugares. Operadores new y delete Para manejar la memoria libre, C++ dispone de los operadores new y delete. Operador new El operador new asigna recursos de memoria para un objeto del tipo y tamaño especificados. En el caso de arrays, el tamaño se especifica explícitamente. En otros casos el tamaño viene definido por el propio tipo. El operador new devuelve un puntero a un objeto del tipo especificado que referencia el espacio reservado. Si no hay espacio para crear un objeto del tipo especificado, el operador new devuelve un puntero nulo ( 0 o NULL ). int n_elementos; cin >> n_elementos; int *a = new int [n_elementos]; // creación //dinámica del array a long *pl = new long; // asignación para un //long, notación sin paréntesis float *pf = new(float); //asignación para //un float, notación funcional struct complejo { float re, im; }; complejo *pc = new complejo; // asignación //para una estructura Si el tipo especificado es un array, el operador new devolverá un puntero al primer elemento de dicho array. Las dimensiones para crear un array pueden ser expresiones. int cols = 10; int filas = 5; double **puntArr = new double[filas * 2][cols]; En este ejemplo declara un puntero puntArr a un array de dos dimensiones dadas por las por las expresiones filas * 2 y cols. Cuando en la expresión que sigue al operador new para especificar el tipo aparece entre paréntesis, es obligatorio utilizar la versión con paréntesis del operador new (notación funcional). int (**puntArr fn)( ); puntArr fn = new(int (*[20] )( )); En este ejemplo, new asigna memoria para un array de punteros de 20 elementos a funciones que no requieren argumentos y que devuelven un entero. Si en la anterior instrucción no se utiliza la notación funcional, el compilador muestra un error. Es decir. new int (*[30] )( ); // error Es un error que se analiza como: ( new int )(*[30] )( ); // error El operador global ::new aparece originalmente declarado como void *operador new ( size_t tamaño_en_bytes_del_objeto); Según esto en los ejemplos anteriores no se ha declarado explícitamente el tamaño en bytes. Esto se debe a que es el sistema el que realiza automáticamente el cálculo a partir del tipo definido. El operador new asigna memoria de un área de memoria del programa conocida como "free store". Sobrecargando new Una clase también puede gestionar por si misma el espacio de memoria libre que se necesita para la creación de objetos. Para ello es necesario definir los operadores new y delete como funciones miembro de la clase. El operador new llamará a la función operator new, y el operador delete llamará a la función operator delete. Cuando se sobrecarguen estos operadores, la definición de estas funciones necesitan unos requerimientos que se comentan a continuación. Asignar memoria: operator new Si en un programa encontramos una instrucción como la siguiente, se invoca la función operator new para asignar un espacio del mismo tamaño especificado en bytes. Una llamada al operador new invoca una llamada al constructor de la clase. int *pint = new int [TMAX]; Si no hubiera suficiente espacio de memoria para la asignación requerida, esta función devolverá NULL. Cuando el operador new se utiliza para asignar memoria para un objeto de una clase que no tiene definido el operador new, o para un array de cualquier tipo se invoca a la función global ::new. Este operador se define de la forma. void *operator new (new_t tamaño); En el caso de que operador new se utilice para asignar memoria de un objeto de una clase con un operador new definido, entonces se invoca a la función operator new de esa clase: nombre_clase::operador new; La función operator new definida en una clase es necesario que sea una función miembro estática por lo tanto, no puede ser virtual, pues debe devolver void* y tener un primer argumento del tipo size_t. Este argumento recibirá automáticamente un valor en bytes igual al tamaño a asignar. El tipo size_t se encuentra definido en el fichero de cabecera stddef.h. Al ejecutar new, el compilador busca una definición para este operador en la clase del objeto a crear; si no la encuentra ejecuta el operador global ::new Operador delete El operador delete destruye un objeto previamente creado por el operador new, de este modo libera la memoria que ocupaba dicho objeto. El operador delete sólo se puede aplicar a punteros si estos han sido retornados a través del operador new. Un puntero a una constante no se puede borrar. Sin embargo, si se puede aplicar delete a un puntero nulo ( un puntero con valor cero ). int *p, *parray; ... p = new int [n]; parray = new int [n]; ... delete p; delete [ ] parray; En las líneas de arriba, la primera intrucción delete libera la memoria apuntada por p y asignada a un entero. La segunda línea delete libera la memoria apuntada por parray y asignada a un array. La sintaxis varía en el caso de tener que liberar la memoria ocupada por un array. En este caso, el compilador deberá invocar al destructor apropiado para cada elemento del array, desde parray[0] a parray[n-1]. El operador global ::delete aparece originalmente declarado de la forma siguiente: void *operator delete(void *puntero_al_objeto); void *operator delete(void *puntero_al_objeto, size_t tamaño); Se puede ver que no se ha declarado explícitamente el tamaño en bytes. Esto es así porque es el sistema el que realiza automáticamente el cálculo. Liberar memoria: operator delete Cuando en un programa se encuentra una sentencia como alguna de las siguientes, la función operator delete se invoca para liberar la memoria asignada por new. Una llamada al operator delete ejecuta una llamada del destructor de la clase. delete c1; delete []c3; Se puede escribir la función miembro operator delete de dos formas: void operator delete (void *); void operator delete (void *, size_t ); La función operator delete puede ser de ámbito global, o de la clase. La función global, en caso de ser definida, toma un único argumento de tipo void*. La función operator delete con dos parámetros es muy útil cuando la utilizamos desde su clase base para eliminar un objeto de una clase derivada. Es necesario que una función operator delete definida en una clase tiene que ser una función miembro estática ( por lo tanto, no puede ser virtual ), esta debe tener como tipo del resultado void y un primer argumento de tipo void*. También se puede añadir un segundo argumento de tipo size_t, el cual debemos inicializar con el compilador con el tamaño en bytes del objeto direccionado por el primer argumento. El tipo size_t se encuentra definido en el archivo de cabecera stddef.h.